août 21, 2026
Cette semaine, une idée m’a trotté dans la tête : nos smartphones, souvent plus récents que nos PC ou Mac (comme mon iPhone 15), regorgent d’une puissance de calcul sous-exploitée. Assez pour faire tourner des modèles comme Gemma4 via Edge Gallery de Google. (D’ailleurs, testez-le si ce n’est pas déjà fait : c’est bluffant !)
Petit exemple concret : lors d’un récent séjour en Allemagne, sans réseau, j’ai utilisé cette solution pour une traduction. Ça m’avait bien dépanné !
Mais revenons à ma réflexion : et si notre ordinateur pouvait se connecter directement au LLM hébergé sur notre téléphone ?
Cela répondrait à plusieurs enjeux majeurs, y compris la pénurie actuelle de composants électroniques :
✅ Zéro dépendance au cloud : Tout se passe en local, entre vos appareils.
✅ Confidentialité et réactivité : Vos données restent chez vous, sans latence.
✅ Un écosystème intelligent : Le téléphone devient le "cerveau IA" central, interconnecté avec vos autres outils.
Une utopie ? Peut-être. Mais une piste réaliste pour repenser notre rapport à l’IA.
💬 Et vous, que pensez-vous de cette idée ?
août 18, 2026
Et Liquid AI vient une nouvelle fois de faire parler de lui.
J’avais déjà évoqué Liquid AI il y a quelques mois, lorsqu’ils proposaient un modèle de raisonnement capable de tenir dans un smartphone (voir mon précédent post).
Cette fois-ci, on ne parle plus simplement de faire tourner un petit LLM localement pour discuter avec un chatbot.
Avec leur nouveau modèle LFM2.5-2.6B, Liquid AI pousse l’idée un cran plus loin : faire tourner un agent autonome directement sur l’appareil. Et pas n’importe quel appareil.
👉 Pas de cloud.
👉 Pas besoin de GPU.
👉 Potentiellement un simple Raspberry Pi.
L’intérêt ? Un modèle capable non seulement de générer du texte, mais aussi de raisonner, utiliser des outils et enchaîner des actions, tout en restant local.
C’est une évolution que je trouve particulièrement intéressante pour l’Edge AI : on passe progressivement de « l’IA qui répond » à « l’IA qui agit », directement au plus près de la donnée et de l’utilisateur.
L’Edge AI tient ici véritablement un rôle important.
Cela ouvre évidemment beaucoup de possibilités : objets connectés, robotique, industrie, domotique, systèmes embarqués… avec en bonus moins de dépendance au cloud et davantage de contrôle sur les données, comme je l’évoquais déjà dans un précédent post sur le sujet (Edge AI vs Cloud AI : un arbitrage devenu critique).
L’Edge AI n’est clairement plus seulement une question de faire rentrer un modèle dans un petit appareil.
La prochaine étape, c’est d’y faire rentrer des agents capables d’agir. 🤖
Et finalement, c’est peut-être ça qui me fascine le plus dans la période que nous vivons : il devient difficile de suivre toutes les évolutions tant les choses changent rapidement.
Il y a encore quelques mois, faire tourner un modèle de raisonnement sur un smartphone semblait déjà impressionnant. Aujourd’hui, on parle d’agents autonomes capables d’agir localement sur des appareils aussi modestes qu’un Raspberry Pi.
Qu’est-ce qu’on considérera comme impossible aujourd’hui qui nous semblera complètement banal dans 12 mois ? 🤔
Source: https://www.liquid.ai/blog/lfm2-5-2-6b
août 11, 2026
Anthropic annonce hier que Claude va intégrer des marqueurs permettant d’identifier, par machine, du contenu généré ou traité par Claude.
Cette démarche s’inscrit dans les engagements pris par Anthropic dans le cadre de l’article 50(2) de l’AI Act européen, consacré à la transparence des contenus générés par IA. Les obligations de transparence de l’article 50 de l’AI Act sont d’ailleurs applicables depuis le 2 août 2026.
Il y aura essentiellement deux mécanismes :
➡️ Pour le texte : un watermark invisible
Claude incorporera directement dans le texte un marquage imperceptible qui ne modifie ni le sens, ni la lisibilité du texte. Il accompagnera le texte lorsqu’on le copie-colle et pourra survivre à certaines modifications ou éditions.
➡️ Pour les fichiers : des métadonnées de provenance signées
Pour certains formats générés par Claude, notamment image comme .svg, .png et .jpg, Anthropic ajoutera des métadonnées de provenance en s’appuyant sur le standard ouvert C2PA (standard ouvert qui permet d’attacher à un contenu des informations vérifiables sur sa provenance et son historique de création ou de modification). Ces métadonnées permettent notamment de vérifier qu’un fichier a été traité par Claude et de détecter certaines altérations.
Tout ceci me rappelle le watermarking utilisé dans le monde du streaming, même si l’objectif est ici différent : il ne s’agit pas d’identifier un utilisateur final, mais de pouvoir détecter qu’un contenu a potentiellement été traité par Claude.
💡 En résumé, Claude introduit une couche de traçabilité machine-readable de ses productions. Et c’est probablement là le point le plus intéressant : cette traçabilité porte sur le fait que Claude a traité le contenu, pas nécessairement sur son origine intellectuelle. Un contenu peut donc être marqué parce que Claude l’a traduit, reformulé ou simplement édité, sans pour autant que Claude en soit à l’origine.
❓ Une question me vient alors, et je n’ai pas encore la réponse : quelles sont les implications de ce mécanisme au regard du RGPD et du respect de la vie privée ? Que contient exactement ce marqueur ? Peut-il permettre, directement ou indirectement, de faire le lien avec l’utilisateur, l’organisation ou le contexte dans lequel le contenu a été produit ?
Ami(e)s juristes si vous voulez partager votre avis !
Le sujet de la traçabilité des contenus générés par IA ouvre donc aussi une nouvelle question : jusqu’où peut-on tracer un contenu sans tracer la personne qui l’a produit ou utilisé ?
Source: le blog post d'Anthropic https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content
août 05, 2026
Oui, vous avez bien lu. Pas un Raspberry Pi, pas un smartphone... un microcontrôleur à quelques euros.

Pour ceux qui ne connaissent pas, un ESP32 est un microcontrôleur très utilisé dans les objets connectés (domotique, capteurs, robots, électronique embarquée). Il coûte quelques euros et dispose de ressources extrêmement limitées : mémoire rapide \< 1Mo et quelques Mo de Flash. On est à des années-lumière des ressources dont dispose le moindre PC moderne.
Avant toute chose, il s'agit d'une preuve de faisabilité (PoC). Ce n'est pas un concurrent de ChatGPT, mais une démonstration extrêmement intéressante d'optimisation logicielle.
❓ Qu'a-t-il modifié ?
Non seulement il a compressé le modèle mais en plus l’auteur a repensé la manière dont le modèle utilise la mémoire :
- le cœur du Transformer (environ 560 000 paramètres) reste dans la mémoire rapide ;
- les 25 millions de paramètres sont stockés dans la mémoire Flash, beaucoup plus grande mais plus lente ;
- les données ne sont lues qu'au moment où elles sont réellement nécessaires
Résultat : environ 9 tokens par seconde sur un ESP32-S3.
🤯 Pourquoi est-ce possible ?
On ne parle pas 29 millions de paramètres manipulés à chaque token généré. En réalité, ici, une grande partie des paramètres est stockée sous forme d'une immense table de correspondance. À chaque génération de token, seule une infime partie est consultée. Cette architecture permet donc de conserver l'essentiel du modèle dans la mémoire Flash tout en gardant uniquement les éléments critiques dans la mémoire rapide.
C'est cette séparation intelligente entre stockage et mémoire de calcul qui rend le PoC possible.
❓ Quels pourraient être les usages ?
Ca ne remplace pas les grands modèles, en revanche, on peut imaginer :
➡️ des assistants ultra-spécialisés embarqués dans une machine industrielle ;
➡️ le pilotage d'un équipement en langage naturel, sans connexion au cloud ;
➡️ des objets connectés capables de dialoguer localement tout en préservant la confidentialité des données.
Ce qui me fascine le plus n'est finalement pas le LLM lui-même. Ceci me rappelle l’époque où l'on cherchait à repousser les limites du matériel grâce à l'ingéniosité du logiciel. Aujourd'hui, la puissance de calcul disponible masque souvent ce type de travail d'optimisation, même si le monde de l'embarqué continue à cultiver cette approche.
Pour moi, l'innovation n'est donc pas d'avoir mis un LLM sur un ESP32. Elle est d'avoir démontré qu'en exploitant intelligemment la hiérarchie mémoire, on peut repousser très loin les limites apparentes du matériel.
💬 Et vous, quel objet du quotidien gagnerait, selon vous, à embarquer un petit LLM fonctionnant entièrement en local, sans dépendre du cloud ?
Source: https://github.com/slvDev/esp32-ai
juil. 15, 2026
Je suis récemment tombé sur une ressource fascinante : une chronologie interactive qui retrace l’évolution des grands modèles de langage (LLMs), de Transformer (2017) jusqu’aux modèles les plus récents. Cette chronologie sur https://llm-timeline.com/ est une excellente façon de prendre du recul sur l’évolution de l’IA générative et de mesurer le chemin parcouru depuis 2017.
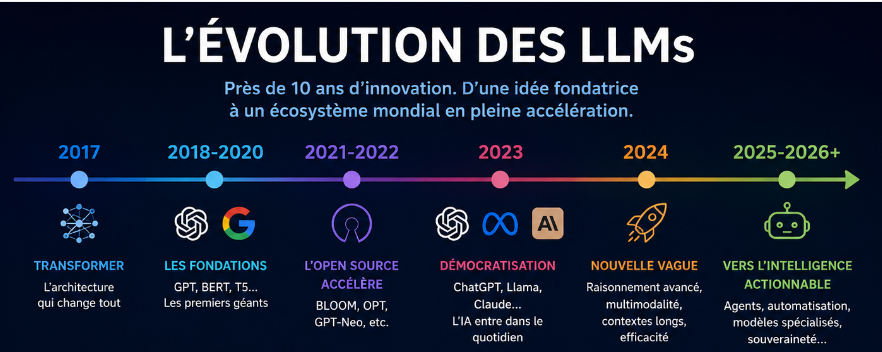
En la parcourant, deux choses m’ont frappé. La première est que les architectures fondatrices des LLM modernes ont près de dix ans. La seconde est que ce n’est plus seulement la vitesse à laquelle les modèles se succèdent qui est frappante, c’est la densité de l’innovation.
En quelques années, nous sommes passés :
➡️ des premiers modèles démontrant le potentiel des Transformers,
➡️ à la démocratisation des LLMs,
➡️ puis à une concurrence mondiale où chaque acteur cherche à repousser une limite différente.
Aujourd’hui, comparer les modèles uniquement par leur nombre de paramètres n’a plus beaucoup de sens. Les questions que l’on se pose sont désormais bien plus concrètes :
• Peut-il utiliser efficacement des outils, des API ou des bases de connaissances ?
• Quel est son coût d’utilisation… et son coût à grande échelle ?
• Peut-il fonctionner en local pour répondre aux exigences de sécurité et de souveraineté ?
• Quelle est sa consommation de ressources (GPU, mémoire, énergie) ?
• Est-il suffisamment rapide pour être utilisé en production ?
• Peut-il être personnalisé ou affiné pour répondre à des besoins métiers ?
Au fond, il semble que l’on ne compare plus seulement des modèles. On compare des solutions capables de répondre à des contraintes métier, techniques, économiques et réglementaires.
En observant cette chronologie, on réalise aussi que l’innovation ne vient plus d’un seul laboratoire. OpenAI, Anthropic, Google, Meta, Mistral AI, xAI, DeepSeek, Alibaba, Zhipu AI… chacun contribue à accélérer le rythme. Et d’autres acteurs pourraient arriver dans un futur proche.
Finalement, le défi n’est peut-être plus de savoir quel est le « meilleur » LLM.
Le véritable enjeu est de comprendre dans quels cas d'usage chaque génération de modèles apporte une nouvelle valeur.
Et vous, quel modèle, quelle avancée ou quel cas d’usage vous a le plus marqué ces dernières années ?
juin 25, 2026
Depuis plusieurs années, Nvidia domine le marché des puces pour l’IA avec ses GPU captant plus de 80 % des parts de marché dans les data centers. Cette année 2026 marquerait un tournant, car le paysage évolue rapidement. L’inférence, le processus où un modèle (ChatGPT, Mistral) entraîné utilise de nouvelles données pour produire une réponse, est le terrain de jeu d’une bataille qui s’annonce féroce. Et pour cause : elle représente jusqu’à 90 % des coûts opérationnels des grands modèles de langage.
De « nouveaux » acteurs (ils ne sont au final pas si nouveau ! ) bousculent le marché :
🔹 OpenAI & Broadcom :
L’annonce a été faite ces derniers jours. Avec Jalapeño, leur première puce dédiée à l’inférence, ils visent une réduction de 50 % des coûts et un déploiement massif dans des data centres géants avec Microsoft.
🔹 Huawei :
Le géant chinois mise sur son Ascend 910. Deepseek (un LLM d’origine chinoise) a d’ailleurs dans sa dernière version optimisé l’usage de ces puces par rapport aux puces concurrentes (Nvidia ou AMD). Une alternative pour la Chine avec des performances qui commencent à être un sérieux rival.
🔹 AMD :
Avec ses Instinct MI450 et MI500, AMD propose une alternative 15 à 20 % moins chère que Nvidia, tout en restant compatible avec les frameworks existants.
Quels sont les avantages d’avoir un choix dans les puces ?
✅ Baisse des coûts : La concurrence pousse les prix à la baisse, une aubaine pour les entreprises.
✅ Innovation accélérée : Plus d’acteurs = plus de choix et de solutions adaptées.
✅ Moins de dépendance : Diversifier les fournisseurs réduit les risques (techniques, géopolitiques).
Alors, Nvidia, prêt à partager ton gâteau ? *🎂 *
Avec l’arrivée de Jalapeño, Ascend 910C et les Instinct d’AMD, le marché des puces IA devient enfin un vrai buffet à volonté… et c’est une excellente nouvelle pour tout le monde (sauf peut-être pour Jensen Huang).
juin 04, 2026
C'est suite à la lecture de cet article ByteDance prépare ses propres CPU Arm et RISC-V pour reprendre le contrôle du coût par token que me vient cette réflexion. L’ère de l’IA ne se résume plus à une course aux GPU. Et pour cause, avec l’essor des agents autonomes, les besoins en infrastructure ont radicalement changé. Il semble que l'on passe en effet d’un monde dominé par le GPU... à une dépendance multi-composants.
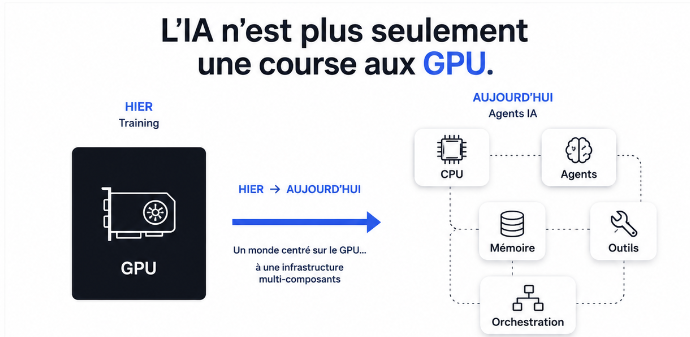
Jusqu’à récemment, l’entraînement des grands modèles de langage (LLM) reposait presque exclusivement sur des GPU haut de gamme, avec NVIDIA en position de monopole. Résultat :
-
Coûts élevés : Les entreprises dépendent d’un seul fournisseur, avec des marges et des prix imposés. Même, comme j’en parlais précédemment, le local AI est envisageable.
-
Goulot d’étranglement : La demande en GPU explose, mais l’offre reste limitée (et chère).
Mais voici qu'un nouveau problème arrive. Les agents IA ne se contentent pas d’un simple appel à un LLM (les fameux modèles). Ils nécessitent :
-
Orchestration complexe (appels à des outils externes, gestion de la mémoire, raisonnement multi-étapes).
-
Mémoire massive pour maintenir le contexte et les états.
-
Et potentiellement même du calcul hybride : GPU pour l’inférence, mais CPU spécialisés pour tout le reste.
La question qui se pose maintenant est qui contrôlera l’infra de demain ?
Tout ceci devient un enjeu stratégique. Et ça bouge à travers le monde. Un petit état des lieux:
-
NVIDIA domine toujours et fournit le marché en GPU, mais son hégémonie est contestée.
-
La Chine via par exemple ByteDance (TikTok) et Huawei investissent massivement dans leurs propres équipement (ARM, RISC-V) pour offrir des gains dans les coûts par token, maîtriser leur chaîne d’approvisionnement (et éviter les risques géopolitiques) et enfin, pourquoi pas, créer un avantage concurrentiel en optimisant leur infrastructure pour leurs besoins spécifiques.
-
L’Europe n’est pas en reste. On voit des gros acteurs comme Mistral et OVH qui investisse dans l’infrastructure nécessaire afin de proposer des solutions IA. Même si ils dépendant des fournisseurs de semi-conducteurs non européen.
🤔 Maintenant qu’est-ce que cela signifie pour les entreprises?
Si vous utilisez des solutions d’IA générative ou des agents, voici ce que je suggérerais :
-
Diversifiez ses dépendances
-
Anticipez au maximum les coûts cachés
-
Rester en veille sur les alternatives : Les prochaines générations de CPU spécialisés pourraient bouleverser le marché
Au final, cette approche n’est pas inconnue, elle a déjà été utilisée par le passé.
juin 04, 2026
Après l’ère des abonnements illimités, les géants comme GitHub Copilot ou Claude ont récemment annoncé le basculement vers une tarification basée sur l’usage des tokens. Finie la consommation sans limite : chaque mot, chaque virgule, chaque espace compte désormais.
Pourquoi ce changement ?
Parce que le coût de l’intelligence artificielle explose. Comme le souligne Madrona, l’optimisation des tokens ("tokenmaxxing") devient un enjeu stratégique. Et avec des modèles toujours plus gros la vitesse et l’efficacité ne sont plus des options, ce sont des nécessités. Des innovations comme le Multi-Token Prediction (MTP), désormais disponible dans Gemma 4 ou via llama.cpp, optimisent déjà la génération des tokens. Pourtant, cela ne suffit pas.
Avec la fin des usages illimités, une question s’impose : comment optimiser chaque token, au-delà des améliorations logicielles comme le MTP ? La réponse pourrait bien résider dans une nouvelle génération d’outils intermédiaires que j'appelerais des wrappers d’IA. Ces outils, placés avant, pendant ou après l’appel au LLM, ont un seul but : réduire le gaspillage de tokens tout en améliorant la qualité des résultats. Quelques exemples concrets :
- Prétraitement des données : Pourquoi envoyer un PDF brut à un LLM quand un wrapper peut en extraire uniquement les parties utiles ?
- Conversion de formats : Des outils comme celui de Cloudflare transforment du HTML en Markdown, évitant d’envoyer des balises inutiles au modèle.
- Optimisation des prompts : Reformuler une requête pour la rendre plus concise, sans perdre son sens.
- Post-traitement : Nettoyer ou structurer la réponse du LLM pour éviter de payer pour des tokens superflus.
🔥 Une opportunité... ou une course déjà lancée ?
Cette transition de la gestion des tokens ouvre un nouveau marché. Des startups sont-elles déjà en train de se positionner sur ce créneau ?
- Des solutions clés en main pour diviser par 2 (ou plus) la facture IA pourraient émerger.
- Les fournisseurs de LLM pourraient intégrer ces optimisations nativement dans leurs APIs.
- Les entreprises qui maîtriseront ces outils gagneront un avantage compétitif en réduisant leurs coûts… tout en gardant la même qualité.
❓ Et si, au final, tout cela était logique ?
On optimise l’entrée, on optimise la sortie... pour obtenir le traitement le plus efficace possible. Après tout, n’est-ce pas la base de toute bonne ingénierie ?
💬 Et vous, comment vous préparez-vous à ces nouvelles contraintes sur les tokens ?
- Avez-vous déjà testé des wrappers pour optimiser vos appels aux LLM ?
- Pensez-vous que cette course à l’efficacité va accélérer l’innovation… ou complexifier l’accès à l’IA pour les petits acteurs ?
mai 21, 2026
Il y a un mois, je partageais cette vidéo expliquant les bases des LLM en 1 minute. Aujourd’hui, je passe à l’étape supérieure en découvrant "LLM from Scratch" : un workshop où je peux mettre les mains dans la machine. En une soirée et avec un peu de Python, ce workshop nous lance dans la création d'un petit LLM. Cela a piqué ma curiosité. Grâce à ce workshop, je comprends mieux les concepts fondamentaux derrière ces modèles. Et c’est bien moins flippant que ce qu’on imagine !
Prérequis : Connaître un minimum le language Python (si vous savez faire un print("Hello World"), vous êtes qualifiés 🥳 ).
Au programme et sans spoiler :
✅ Étape 1 : La "tokenisation", ou "comment transformer du texte en Lego pour l’ordinateur".
✅ Étape 2 : Les "embeddings", ou "pourquoi votre chat et mon chat ne sont pas le même chat pour l’IA" (spoiler : c’est une histoire de maths).
✅ Étape 3 : L’assemblage, ou "comment faire croire à votre PC qu’il est intelligent" (il ne l’est pas. Désolé.).
✅ Étape 4 : La génération de texte, ou "comment faire parler votre modèle... même s’il dit parfois des bêtises".
Pourquoi c’est cool ?
- Plus besoin de faire semblant de comprendre quand on me parlera de transformers et je ne parle pas du film.
- Lors de ma prochaine soirée mondaine, je pourrais dire : "Moi aussi, j’ai codé un LLM... enfin, un mini-LLM. Mais c’est déjà ça !"
- Je serais en mesure d'expliquer à mon étourage c’est qu’un LLM avec un peu plus de détails... sans avoir l’air de réciter un cours.
🫵 À vous de jouer !
Pour les ambitieux: si cela vous a donné envie d’aller plus loin, ce livre "Build a Large Language Model from Scratch" semble être une bonne référence pour avancer sur votre prochain défi. Attention, votre cerveau pourrait vous en vouloir... mais au moins, vous saurez pourquoi ! 😂
avril 06, 2026
Au début, l’IA (celle qui a explosé avec ChatGPT) rimait avec cloud : puissance déportée, dépendance aux API, latence acceptée comme une certaine fatalité. Et puis, progressivement — presque silencieusement ? — le centre de gravité se rapproche de nos propres machines. Une évolution que je suis depuis un moment, et j’ai l'impression qu’un vrai basculement est en train de se produire.

Ce week-end, Apple a discrètement fait un pas majeur : approbation officielle du pilote de Tiny Corp pour prendre en charge les eGPU NVIDIA sur Mac. Ce pilote est pensé pour l’IA, pas pour les jeux ou usages généraux.
Le message est clair : l’IA locale, embarquée et maîtrisée, devient une réalité. Une IA qui ne dépend plus d’un serveur distant, mais de votre propre matériel — confidentialité, réactivité et souveraineté garanties.
Les puces Apple sont déjà puissantes : M1 à M5 offrent un CPU ultra-optimisé capable de gérer inférence, pipelines rapides et orchestration. Avec un eGPU externe, elles peuvent désormais être associées pour des calculs encore plus ambitieux. Ces associations sont d'ailleurs déjà possible sur PC traditionnel depuis quelques temps.
Concrètement, on peut imaginer :
-
Des copilotes privés ultra-efficient et 100% offline , sans risque d’exposition des données
-
Des outils avancés de création (texte, image, code), fonctionnant en local, sans abonnement ni latence
-
Des workflows IA embarqués dans des apps métiers, pour une réactivité immédiate
-
Des environnements de test rapides, sans friction ni coût variable
On passe d’une logique de consommation à une logique d’appropriation. Plus besoin de dépendre d’une connexion ou d’un budget API pour innover.
La vraie question : comment orchestrer ces synergies CPU+eGPU pour rivaliser, sur certains usages, avec le cloud ? Bien sûr, le cloud reste roi pour le scale, mais "local" ne veut plus dire "limité". Et ça, c’est profondément excitant pour l’avenir de l’IA sur toutes les plateformes.

