août 21, 2026
Cette semaine, une idée m’a trotté dans la tête : nos smartphones, souvent plus récents que nos PC ou Mac (comme mon iPhone 15), regorgent d’une puissance de calcul sous-exploitée. Assez pour faire tourner des modèles comme Gemma4 via Edge Gallery de Google. (D’ailleurs, testez-le si ce n’est pas déjà fait : c’est bluffant !)
Petit exemple concret : lors d’un récent séjour en Allemagne, sans réseau, j’ai utilisé cette solution pour une traduction. Ça m’avait bien dépanné !
Mais revenons à ma réflexion : et si notre ordinateur pouvait se connecter directement au LLM hébergé sur notre téléphone ?
Cela répondrait à plusieurs enjeux majeurs, y compris la pénurie actuelle de composants électroniques :
✅ Zéro dépendance au cloud : Tout se passe en local, entre vos appareils.
✅ Confidentialité et réactivité : Vos données restent chez vous, sans latence.
✅ Un écosystème intelligent : Le téléphone devient le "cerveau IA" central, interconnecté avec vos autres outils.
Une utopie ? Peut-être. Mais une piste réaliste pour repenser notre rapport à l’IA.
💬 Et vous, que pensez-vous de cette idée ?
août 18, 2026
Et Liquid AI vient une nouvelle fois de faire parler de lui.
J’avais déjà évoqué Liquid AI il y a quelques mois, lorsqu’ils proposaient un modèle de raisonnement capable de tenir dans un smartphone (voir mon précédent post).
Cette fois-ci, on ne parle plus simplement de faire tourner un petit LLM localement pour discuter avec un chatbot.
Avec leur nouveau modèle LFM2.5-2.6B, Liquid AI pousse l’idée un cran plus loin : faire tourner un agent autonome directement sur l’appareil. Et pas n’importe quel appareil.
👉 Pas de cloud.
👉 Pas besoin de GPU.
👉 Potentiellement un simple Raspberry Pi.
L’intérêt ? Un modèle capable non seulement de générer du texte, mais aussi de raisonner, utiliser des outils et enchaîner des actions, tout en restant local.
C’est une évolution que je trouve particulièrement intéressante pour l’Edge AI : on passe progressivement de « l’IA qui répond » à « l’IA qui agit », directement au plus près de la donnée et de l’utilisateur.
L’Edge AI tient ici véritablement un rôle important.
Cela ouvre évidemment beaucoup de possibilités : objets connectés, robotique, industrie, domotique, systèmes embarqués… avec en bonus moins de dépendance au cloud et davantage de contrôle sur les données, comme je l’évoquais déjà dans un précédent post sur le sujet (Edge AI vs Cloud AI : un arbitrage devenu critique).
L’Edge AI n’est clairement plus seulement une question de faire rentrer un modèle dans un petit appareil.
La prochaine étape, c’est d’y faire rentrer des agents capables d’agir. 🤖
Et finalement, c’est peut-être ça qui me fascine le plus dans la période que nous vivons : il devient difficile de suivre toutes les évolutions tant les choses changent rapidement.
Il y a encore quelques mois, faire tourner un modèle de raisonnement sur un smartphone semblait déjà impressionnant. Aujourd’hui, on parle d’agents autonomes capables d’agir localement sur des appareils aussi modestes qu’un Raspberry Pi.
Qu’est-ce qu’on considérera comme impossible aujourd’hui qui nous semblera complètement banal dans 12 mois ? 🤔
Source: https://www.liquid.ai/blog/lfm2-5-2-6b
juin 04, 2026
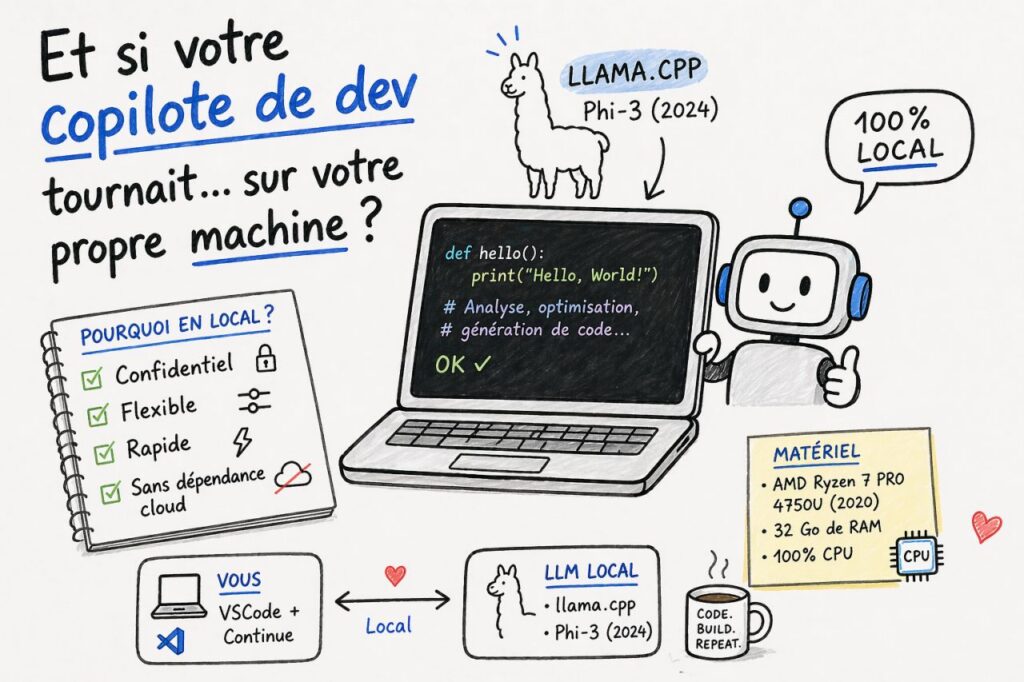
À mes heures perdues (enfin pas tant perdu que cela, j’ai appris des choses), je me suis récemment amusé à tester les copilotes pour développeurs. Vous connaissez sûrement Claude Code ou GitHub Copilot. Ayant lu des messages et articles, j’ai décidé de voir ce type d'assistant donne mais en 100% local, sans dépendance à une solution cloud.
Le résultat est très interessant. Voici mon expérience :
🖥 Matériel : CPU AMD Ryzen 7 PRO 4750U (2020) avec 32 Go de RAM. Pas de GPU puissant, donc tout tourne côté CPU. Ce n’est clairement pas du dernier cri, mais ça fait un bon benchmark, non ?
🛠 Setup : VSCode + extension Continue côté client, et côté serveur… Llama.cpp utilisant le modèle Phi-3 (2024) et un mitmproxy.
Après quelques optimisations, les résultats sont surprenants :
➡️ J’ai commencé simple : un Hello World dans différents langages, généré en quelques secondes. Basique, mais symbolique pour démarrer dans un langage.
➡️ Analyse de code parfaitement fonctionnelle : on sélectionne le code comme contexte et on pose sa question dessus. Deux dizaines de secondes après, on a la réponse.
➡️ Optimisation de la latence : grâce à mitmproxy, j’ai pu surveiller et réduire la quantité de texte envoyée au LLM, ce qui accélère sensiblement les réponses.
Toutes les fonctionnalités attendues d’un copilote sont donc disponible à la différence que tout tourne en local (sur la même machine), avec la confidentialité (rien ne sort de chez vous) et flexible (la bascule d'un modèle LLM à l'autre est simple). En utilisant du matériel récent et notamment un bon GPU, je ne vois pas de limitation pour une grande majorité des cas d’usage.
En bref, faire tourner un assistant de développement en local… ça marche vraiment !
Et le meilleur dans tout ça ? J’utilise cette expérience pour du code, rien n’empêche d’adapter la solution d’utiliser des LLM locaux pour d’autres cas d’usages.
La seule contrainte est le support de la partie serveur décrite plus haut. Entre ça et le suivi de son usage de tokens sur les solutions externes, la question peut se poser.
❓ Et vous, avez-vous déjà essayé un copilote qui fonctionne directement sur votre machine ? L'utilisez-vous au quotidien
Je peux partager plus d’infos techniques dans les commentaires
mai 04, 2026
Lors de ma veille, je suis tombé sur un article intéressant sur l’Edge AI et le Cloud AI dans les environnements industriels : Pourquoi l’intelligence locale est la clé de la productivité industrielle 4.0
Ce que je trouve particulièrement pertinent, c’est la mise en lumière de 3 contraintes structurelles, souvent sous-estimées dans presque tous les domaines, mais encore plus critiques dans l’industrie :
➡ la latence
➡ les coûts de transfert de données
➡ la dépendance à la connectivité
Dans un contexte industriel, ces facteurs ne sont pas de simples “détails techniques” : ils peuvent directement impacter la performance opérationnelle, voire bloquer des cas d’usage temps réel.
Le point que je retiens surtout est la grille de lecture finale :
➡ Cloud AI : analyse stratégique, entraînement, apprentissage, vision long terme
➡ Edge AI : action terrain, temps réel, décision locale
Et surtout, la vraie valeur n’est pas dans l’opposition des deux approches, mais dans leur complémentarité.
On se dirige clairement vers des architectures hybrides (hybrides comme on peut l’observer dans beaucoup de domaines), où :
➡ le cloud structure, apprend et optimise
➡ l’edge exécute, réagit et décide localement
Au final, pour moi la question ne serait plus “Cloud ou Edge”. Mais plutôt : où placer l’intelligence pour maximiser la réactivité, la fiabilité et le ROI ?