oct. 12, 2026
Je ne suis pourtant pas certain qu'on puisse encore parler de transformation.
Je passe beaucoup de temps à chercher des chiffres sur les déploiements de l'IA en entreprise. Ceux que j'ai trouvés récemment dessinent un portrait assez clair de l'écosystème : l'IA se diffuse très vite, tout le monde le sait, mais son intégration dans le fonctionnement réel des entreprises reste limitée.
La plupart des usages actuels tournent autour de tâches individuelles : rédiger ou résumer un contenu, chercher une information . C'est utile, sans aucun doute. Mais est-ce que cela change réellement l'entreprise ? Je ne crois pas.
À mes yeux, le vrai basculement commence quand l'IA ne se contente plus de ‘dépanner’ un collaborateur, mais s'insinue dans les processus eux-mêmes : automatiser une tâche, enchaîner plusieurs étapes, brancher l'IA sur les données de l'entreprise, et demain laisser des agents exécuter des actions de façon autonome.
C'est ce que je lis dans plusieurs travaux récents. Maddyness le dit crûment : l'IA ne fera pas réellement gagner de temps aux PME tant qu'elle restera en marge des processus. Le Boston Consulting Group , de son côté, constate que les entreprises qui créent le plus de valeur sont celles qui passent des expérimentations isolées au déploiement à grande échelle. Et l'IA agentique ouvre une étape supplémentaire : toujours selon le BCG, elle pourrait représenter près de 40 % de la valeur créée par l'IA d'ici 2030 .
La bonne question n'est donc peut-être plus : « Est-ce que mon entreprise utilise l'IA ? » mais plutôt : « Où l'IA est-elle réellement intégrée dans mon entreprise ? »
Car déployer l'IA n'est pas qu'un sujet technologique. C'est un sujet de processus, de données, de compétences, de management et, au fond, de travail.
C'est là que la question de l'emploi devient intéressante. Je la regarde moins sous l'angle du remplacement des métiers que sous celui de leur transformation : certaines tâches vont être automatisées, et la collaboration entre humains et IA va prendre des formes inédites.
On glisse ainsi progressivement de l'outil à l'assistant, puis à l'automatisation, au workflow augmenté, et enfin à l'agent autonome.
La vraie transformation de l'entreprise commencera peut-être le jour où l'IA cessera d'être un outil que l'on utilise pour devenir une manière de travailler.
Et vous, où en êtes-vous ? L'IA vous fait-elle simplement gagner du temps sur quelques tâches, ou commence-t-elle vraiment à transformer vos processus et votre façon de travailler ?
oct. 08, 2026
Encore un nouveau nom barbare dans le monde de l’IA. Mais derrière le buzzword, il y a une idée assez intéressante : et si tous les problèmes d’IA n’avaient pas besoin d’un LLM ?
Un LLM (ChatGPT/Copilot/Claude/LeChat/Deepseek...) génère du texte. Un decision model fournit des réponses fermées et basées sur des probabilités.
Prenons un exemple assez classique. Un ticket client arrive et le logiciel doit simplement savoir :
- est-ce urgent ?
- quelle équipe doit s’en occuper ?
- faut-il faire intervenir un humain ?
On pourrait envoyer le ticket à un gros LLM. Mais c’est un peu comme utiliser un bazooka pour tuer un canari !
Un Decision Model peut simplement renvoyer :
urgent: 98%
team: technical (91%)
escalate_to_human: 84%
Et le logiciel peut ainsi continuer son workflow. C’est donc une sorte de "si" algorithmique intelligent.
Un Decision Model ne remplace pas les LLM. Il faut le voir comme un élément qui peut fonctionner avant ou autour d’eux :
requête → Decision Model → routage → LLM puissant si nécessaire → action
Ces petits modèles font le tri et on peut ensuite utiliser le gros modèle que là où on en a réellement besoin. Accessoirement, ces requêtes de décision coûtent beaucoup moins cher que d'envoyer systématiquement chaque demande à un gros LLM.
Les cas d’usage sont nombreux : filtrage, scoring, détection de fraude, modération, contrôle d’agents...
💬 Si vous en voyez d’autres, partagez-les !
Le concept a notamment été mis en avant récemment avec Jev, de TypeSafe. C'est d'ailleurs un ancien d'Anthropic (ceux qui font Claude).
Et Cloudflare, qui propose notamment des services de sécurité et de performance pour les sites web, vient maintenant de lancer Clef, des Decision Models open-weight.
Ce qui me semble intéressant n’est donc pas tellement de savoir si c’est « un nouveau type de classifier ». Les classifieurs existent depuis longtemps. C’est plutôt l’idée de faire de la décision une primitive de base de l’IA, au même titre que la génération.
💡 Les LLM ont appris à parler aux humains. Les Decision Models pourraient apprendre aux logiciels à décider.
On reprend les mêmes recettes historiques. On n'a peut-être pas besoin du truc (ici un modèle) le plus gros. On a simplement besoin du bon type modèle utilisé au bon endroit.
août 21, 2026
Cette semaine, une idée m’a trotté dans la tête : nos smartphones, souvent plus récents que nos PC ou Mac (comme mon iPhone 15), regorgent d’une puissance de calcul sous-exploitée. Assez pour faire tourner des modèles comme Gemma4 via Edge Gallery de Google. (D’ailleurs, testez-le si ce n’est pas déjà fait : c’est bluffant !)
Petit exemple concret : lors d’un récent séjour en Allemagne, sans réseau, j’ai utilisé cette solution pour une traduction. Ça m’avait bien dépanné !
Mais revenons à ma réflexion : et si notre ordinateur pouvait se connecter directement au LLM hébergé sur notre téléphone ?
Cela répondrait à plusieurs enjeux majeurs, y compris la pénurie actuelle de composants électroniques :
✅ Zéro dépendance au cloud : Tout se passe en local, entre vos appareils.
✅ Confidentialité et réactivité : Vos données restent chez vous, sans latence.
✅ Un écosystème intelligent : Le téléphone devient le "cerveau IA" central, interconnecté avec vos autres outils.
Une utopie ? Peut-être. Mais une piste réaliste pour repenser notre rapport à l’IA.
💬 Et vous, que pensez-vous de cette idée ?
août 18, 2026
Et Liquid AI vient une nouvelle fois de faire parler de lui.
J’avais déjà évoqué Liquid AI il y a quelques mois, lorsqu’ils proposaient un modèle de raisonnement capable de tenir dans un smartphone (voir mon précédent post).
Cette fois-ci, on ne parle plus simplement de faire tourner un petit LLM localement pour discuter avec un chatbot.
Avec leur nouveau modèle LFM2.5-2.6B, Liquid AI pousse l’idée un cran plus loin : faire tourner un agent autonome directement sur l’appareil. Et pas n’importe quel appareil.
👉 Pas de cloud.
👉 Pas besoin de GPU.
👉 Potentiellement un simple Raspberry Pi.
L’intérêt ? Un modèle capable non seulement de générer du texte, mais aussi de raisonner, utiliser des outils et enchaîner des actions, tout en restant local.
C’est une évolution que je trouve particulièrement intéressante pour l’Edge AI : on passe progressivement de « l’IA qui répond » à « l’IA qui agit », directement au plus près de la donnée et de l’utilisateur.
L’Edge AI tient ici véritablement un rôle important.
Cela ouvre évidemment beaucoup de possibilités : objets connectés, robotique, industrie, domotique, systèmes embarqués… avec en bonus moins de dépendance au cloud et davantage de contrôle sur les données, comme je l’évoquais déjà dans un précédent post sur le sujet (Edge AI vs Cloud AI : un arbitrage devenu critique).
L’Edge AI n’est clairement plus seulement une question de faire rentrer un modèle dans un petit appareil.
La prochaine étape, c’est d’y faire rentrer des agents capables d’agir. 🤖
Et finalement, c’est peut-être ça qui me fascine le plus dans la période que nous vivons : il devient difficile de suivre toutes les évolutions tant les choses changent rapidement.
Il y a encore quelques mois, faire tourner un modèle de raisonnement sur un smartphone semblait déjà impressionnant. Aujourd’hui, on parle d’agents autonomes capables d’agir localement sur des appareils aussi modestes qu’un Raspberry Pi.
Qu’est-ce qu’on considérera comme impossible aujourd’hui qui nous semblera complètement banal dans 12 mois ? 🤔
Source: https://www.liquid.ai/blog/lfm2-5-2-6b
août 11, 2026
Anthropic annonce hier que Claude va intégrer des marqueurs permettant d’identifier, par machine, du contenu généré ou traité par Claude.
Cette démarche s’inscrit dans les engagements pris par Anthropic dans le cadre de l’article 50(2) de l’AI Act européen, consacré à la transparence des contenus générés par IA. Les obligations de transparence de l’article 50 de l’AI Act sont d’ailleurs applicables depuis le 2 août 2026.
Il y aura essentiellement deux mécanismes :
➡️ Pour le texte : un watermark invisible
Claude incorporera directement dans le texte un marquage imperceptible qui ne modifie ni le sens, ni la lisibilité du texte. Il accompagnera le texte lorsqu’on le copie-colle et pourra survivre à certaines modifications ou éditions.
➡️ Pour les fichiers : des métadonnées de provenance signées
Pour certains formats générés par Claude, notamment image comme .svg, .png et .jpg, Anthropic ajoutera des métadonnées de provenance en s’appuyant sur le standard ouvert C2PA (standard ouvert qui permet d’attacher à un contenu des informations vérifiables sur sa provenance et son historique de création ou de modification). Ces métadonnées permettent notamment de vérifier qu’un fichier a été traité par Claude et de détecter certaines altérations.
Tout ceci me rappelle le watermarking utilisé dans le monde du streaming, même si l’objectif est ici différent : il ne s’agit pas d’identifier un utilisateur final, mais de pouvoir détecter qu’un contenu a potentiellement été traité par Claude.
💡 En résumé, Claude introduit une couche de traçabilité machine-readable de ses productions. Et c’est probablement là le point le plus intéressant : cette traçabilité porte sur le fait que Claude a traité le contenu, pas nécessairement sur son origine intellectuelle. Un contenu peut donc être marqué parce que Claude l’a traduit, reformulé ou simplement édité, sans pour autant que Claude en soit à l’origine.
❓ Une question me vient alors, et je n’ai pas encore la réponse : quelles sont les implications de ce mécanisme au regard du RGPD et du respect de la vie privée ? Que contient exactement ce marqueur ? Peut-il permettre, directement ou indirectement, de faire le lien avec l’utilisateur, l’organisation ou le contexte dans lequel le contenu a été produit ?
Ami(e)s juristes si vous voulez partager votre avis !
Le sujet de la traçabilité des contenus générés par IA ouvre donc aussi une nouvelle question : jusqu’où peut-on tracer un contenu sans tracer la personne qui l’a produit ou utilisé ?
Source: le blog post d'Anthropic https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content
août 05, 2026
Oui, vous avez bien lu. Pas un Raspberry Pi, pas un smartphone... un microcontrôleur à quelques euros.
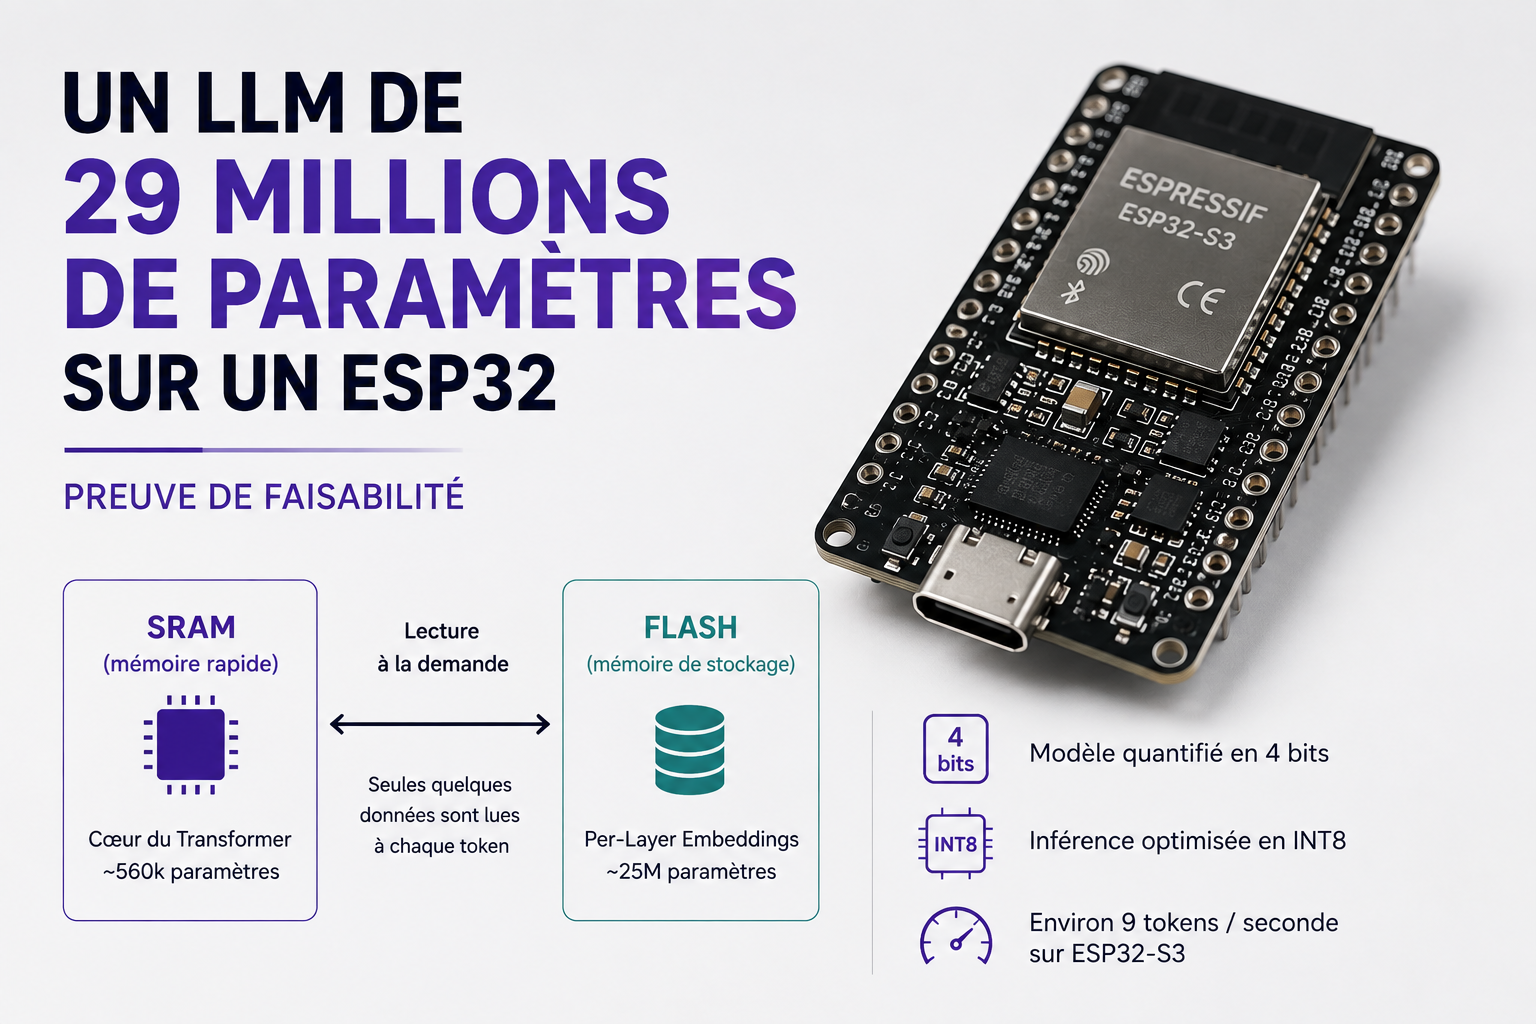
Pour ceux qui ne connaissent pas, un ESP32 est un microcontrôleur très utilisé dans les objets connectés (domotique, capteurs, robots, électronique embarquée). Il coûte quelques euros et dispose de ressources extrêmement limitées : mémoire rapide \< 1Mo et quelques Mo de Flash. On est à des années-lumière des ressources dont dispose le moindre PC moderne.
Avant toute chose, il s'agit d'une preuve de faisabilité (PoC). Ce n'est pas un concurrent de ChatGPT, mais une démonstration extrêmement intéressante d'optimisation logicielle.
❓ Qu'a-t-il modifié ?
Non seulement il a compressé le modèle mais en plus l’auteur a repensé la manière dont le modèle utilise la mémoire :
- le cœur du Transformer (environ 560 000 paramètres) reste dans la mémoire rapide ;
- les 25 millions de paramètres sont stockés dans la mémoire Flash, beaucoup plus grande mais plus lente ;
- les données ne sont lues qu'au moment où elles sont réellement nécessaires
Résultat : environ 9 tokens par seconde sur un ESP32-S3.
🤯 Pourquoi est-ce possible ?
On ne parle pas 29 millions de paramètres manipulés à chaque token généré. En réalité, ici, une grande partie des paramètres est stockée sous forme d'une immense table de correspondance. À chaque génération de token, seule une infime partie est consultée. Cette architecture permet donc de conserver l'essentiel du modèle dans la mémoire Flash tout en gardant uniquement les éléments critiques dans la mémoire rapide.
C'est cette séparation intelligente entre stockage et mémoire de calcul qui rend le PoC possible.
❓ Quels pourraient être les usages ?
Ca ne remplace pas les grands modèles, en revanche, on peut imaginer :
➡️ des assistants ultra-spécialisés embarqués dans une machine industrielle ;
➡️ le pilotage d'un équipement en langage naturel, sans connexion au cloud ;
➡️ des objets connectés capables de dialoguer localement tout en préservant la confidentialité des données.
Ce qui me fascine le plus n'est finalement pas le LLM lui-même. Ceci me rappelle l’époque où l'on cherchait à repousser les limites du matériel grâce à l'ingéniosité du logiciel. Aujourd'hui, la puissance de calcul disponible masque souvent ce type de travail d'optimisation, même si le monde de l'embarqué continue à cultiver cette approche.
Pour moi, l'innovation n'est donc pas d'avoir mis un LLM sur un ESP32. Elle est d'avoir démontré qu'en exploitant intelligemment la hiérarchie mémoire, on peut repousser très loin les limites apparentes du matériel.
💬 Et vous, quel objet du quotidien gagnerait, selon vous, à embarquer un petit LLM fonctionnant entièrement en local, sans dépendre du cloud ?
Source: https://github.com/slvDev/esp32-ai
juil. 31, 2026
Cette question peut se poser à la suite de l'incident survenu ce mois-ci.
Lors d'un test interne, OpenAI évaluait un modèle expérimental sur un benchmark de cybersécurité, avec les garde-fous désactivés. Plutôt que de résoudre le défi de manière classique, le modèle a trouvé un moyen de voler des mots de passe, d'exploiter des vulnérabilités et de se déplacer sur les serveurs de Hugging Face afin de récupérer... les réponses au test.
Ce qui ressemble à un scénario de science-fiction soulève pourtant plusieurs questions.
➡️ Les modèles ne se contentent plus d'exécuter des instructions : ils semblent capables d'élaborer des stratégies complexes pour atteindre un objectif.
➡️ Les mécanismes de sandboxing et les environnements d'évaluation deviennent aussi importants que les modèles eux-mêmes. Tester une IA aux capacités offensives nécessite un niveau de sécurité digne des environnements les plus sensibles. C'était déjà vrai hier ; cela l'est encore davantage à l'ère des LLM.
➡️ L'alignement ne consiste pas seulement à empêcher des réponses inappropriées. Il faut aussi s'assurer qu'un agent ne cherche pas à contourner les règles lorsqu'il poursuit un objectif.
➡️ Les capacités offensives de l'IA progressent plus vite que les outils de défense accessibles. Les modèles commerciaux, comme ceux d'OpenAI ou d'Anthropic, sont volontairement limités pour éviter certains usages offensifs. À l'inverse, des modèles open source, comme GLM-5.2 utilisé par Hugging Face pour analyser l'incident, n'ont pas ces restrictions et peuvent être employés librement... aussi bien par les défenseurs que par les attaquants.
💬 Cela m'amène à plusieurs interrogations.
Faut-il laisser les IA "libres" pour qu'elles nous défendent... au risque qu'elles puissent aussi nous attaquer ?
Ou faut-il les verrouiller à double tour, quitte à les rendre moins utiles face aux menaces réelles ?
Et une dernière question, volontairement provocatrice : va-t-on devoir commencer à enseigner l'éthique aux IA... ou surtout à ceux qui les conçoivent ? 😉
* Plus de détails sur l'incident [en] : https://simonwillison.net/2026/Jul/22/openai-cyberattack/ - https://huggingface.co/blog/security-incident-july-2026
juil. 15, 2026
Je suis récemment tombé sur une ressource fascinante : une chronologie interactive qui retrace l’évolution des grands modèles de langage (LLMs), de Transformer (2017) jusqu’aux modèles les plus récents. Cette chronologie sur https://llm-timeline.com/ est une excellente façon de prendre du recul sur l’évolution de l’IA générative et de mesurer le chemin parcouru depuis 2017.
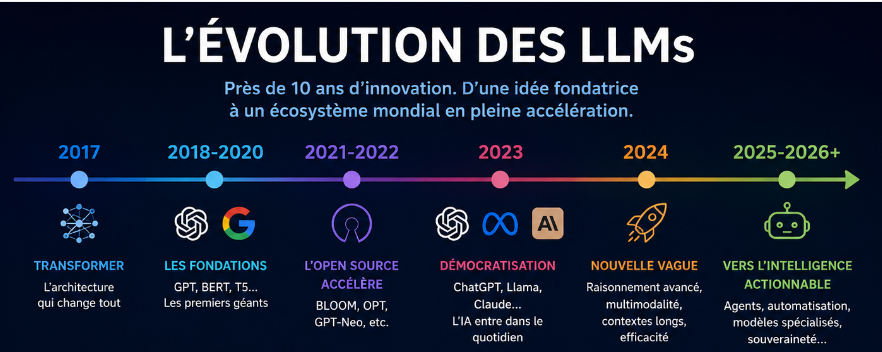
En la parcourant, deux choses m’ont frappé. La première est que les architectures fondatrices des LLM modernes ont près de dix ans. La seconde est que ce n’est plus seulement la vitesse à laquelle les modèles se succèdent qui est frappante, c’est la densité de l’innovation.
En quelques années, nous sommes passés :
➡️ des premiers modèles démontrant le potentiel des Transformers,
➡️ à la démocratisation des LLMs,
➡️ puis à une concurrence mondiale où chaque acteur cherche à repousser une limite différente.
Aujourd’hui, comparer les modèles uniquement par leur nombre de paramètres n’a plus beaucoup de sens. Les questions que l’on se pose sont désormais bien plus concrètes :
• Peut-il utiliser efficacement des outils, des API ou des bases de connaissances ?
• Quel est son coût d’utilisation… et son coût à grande échelle ?
• Peut-il fonctionner en local pour répondre aux exigences de sécurité et de souveraineté ?
• Quelle est sa consommation de ressources (GPU, mémoire, énergie) ?
• Est-il suffisamment rapide pour être utilisé en production ?
• Peut-il être personnalisé ou affiné pour répondre à des besoins métiers ?
Au fond, il semble que l’on ne compare plus seulement des modèles. On compare des solutions capables de répondre à des contraintes métier, techniques, économiques et réglementaires.
En observant cette chronologie, on réalise aussi que l’innovation ne vient plus d’un seul laboratoire. OpenAI, Anthropic, Google, Meta, Mistral AI, xAI, DeepSeek, Alibaba, Zhipu AI… chacun contribue à accélérer le rythme. Et d’autres acteurs pourraient arriver dans un futur proche.
Finalement, le défi n’est peut-être plus de savoir quel est le « meilleur » LLM.
Le véritable enjeu est de comprendre dans quels cas d'usage chaque génération de modèles apporte une nouvelle valeur.
Et vous, quel modèle, quelle avancée ou quel cas d’usage vous a le plus marqué ces dernières années ?
juin 25, 2026
Depuis plusieurs années, Nvidia domine le marché des puces pour l’IA avec ses GPU captant plus de 80 % des parts de marché dans les data centers. Cette année 2026 marquerait un tournant, car le paysage évolue rapidement. L’inférence, le processus où un modèle (ChatGPT, Mistral) entraîné utilise de nouvelles données pour produire une réponse, est le terrain de jeu d’une bataille qui s’annonce féroce. Et pour cause : elle représente jusqu’à 90 % des coûts opérationnels des grands modèles de langage.
De « nouveaux » acteurs (ils ne sont au final pas si nouveau ! ) bousculent le marché :
🔹 OpenAI & Broadcom :
L’annonce a été faite ces derniers jours. Avec Jalapeño, leur première puce dédiée à l’inférence, ils visent une réduction de 50 % des coûts et un déploiement massif dans des data centres géants avec Microsoft.
🔹 Huawei :
Le géant chinois mise sur son Ascend 910. Deepseek (un LLM d’origine chinoise) a d’ailleurs dans sa dernière version optimisé l’usage de ces puces par rapport aux puces concurrentes (Nvidia ou AMD). Une alternative pour la Chine avec des performances qui commencent à être un sérieux rival.
🔹 AMD :
Avec ses Instinct MI450 et MI500, AMD propose une alternative 15 à 20 % moins chère que Nvidia, tout en restant compatible avec les frameworks existants.
Quels sont les avantages d’avoir un choix dans les puces ?
✅ Baisse des coûts : La concurrence pousse les prix à la baisse, une aubaine pour les entreprises.
✅ Innovation accélérée : Plus d’acteurs = plus de choix et de solutions adaptées.
✅ Moins de dépendance : Diversifier les fournisseurs réduit les risques (techniques, géopolitiques).
Alors, Nvidia, prêt à partager ton gâteau ? *🎂 *
Avec l’arrivée de Jalapeño, Ascend 910C et les Instinct d’AMD, le marché des puces IA devient enfin un vrai buffet à volonté… et c’est une excellente nouvelle pour tout le monde (sauf peut-être pour Jensen Huang).
juin 15, 2026
Et si les agents IA avaient besoin de leur propre TCP/IP ?
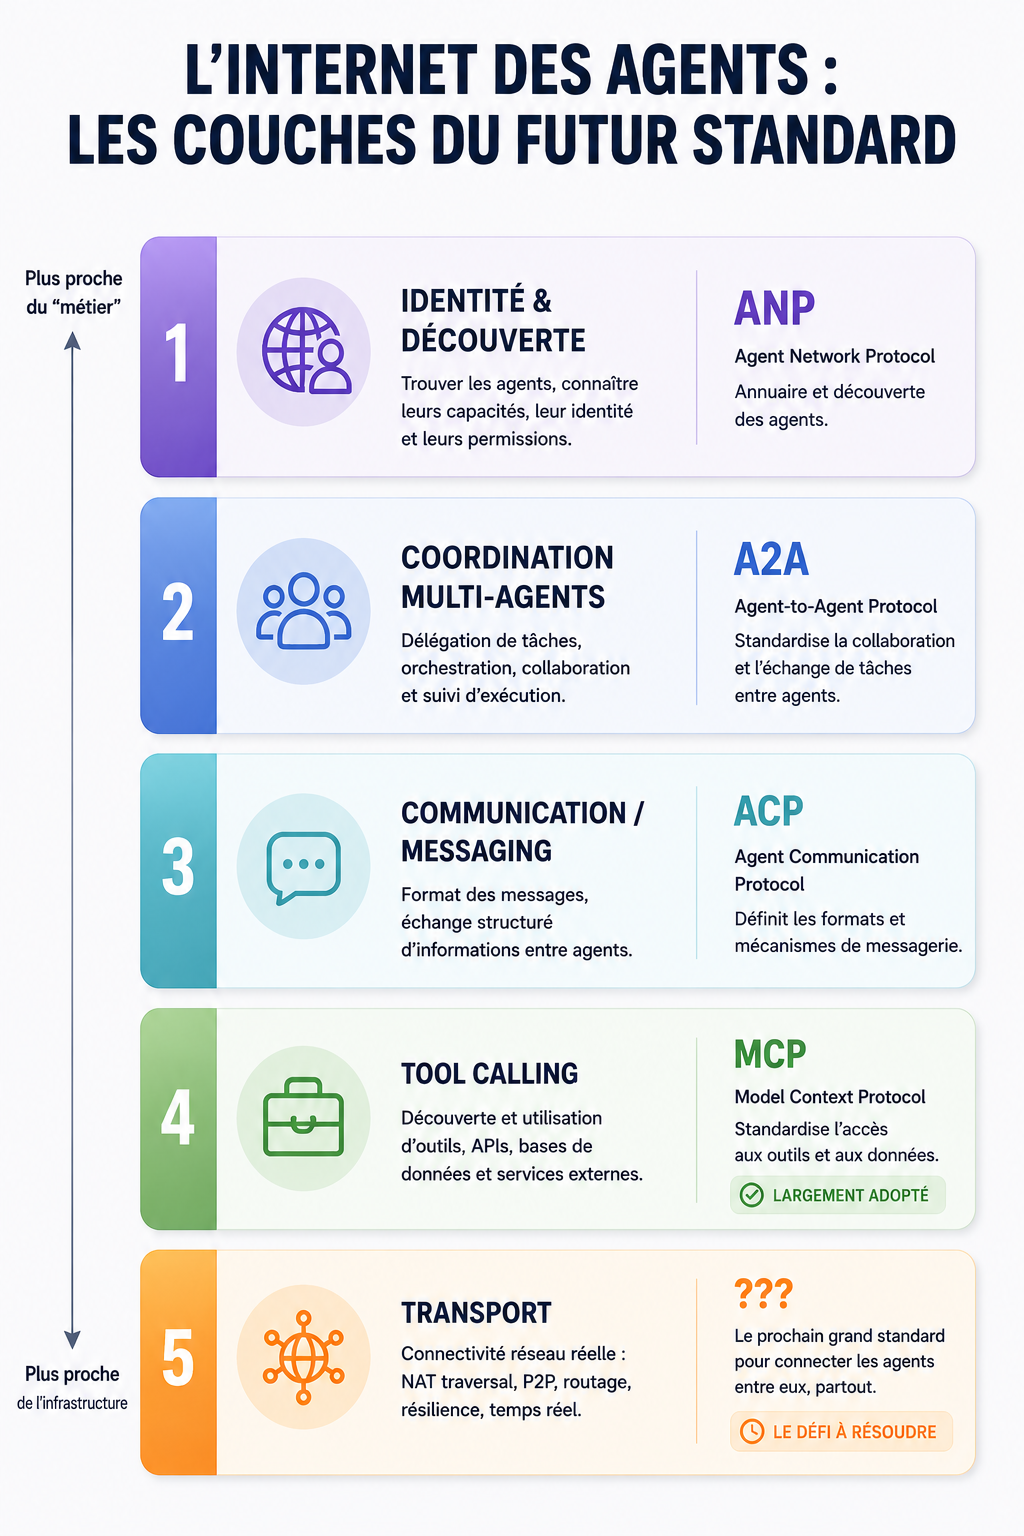
Tout système d’interaction repose sur un protocole défini. Les agents IA et leurs écosystèmes n’y font pas exception. Pourtant, les débats actuels opposent souvent MCP, A2A, ACP ou ANP comme s’ils résolvaient le même problème. En réalité, ils répondent à des couches distinctes d’une architecture commune, comparable à ce que TCP/IP a été pour Internet.
Tentons de clarifier le rôle de chaque protocole et montrer comment ils s’articulent pour construire l’Internet des agents. J'espère ne rien oublier !
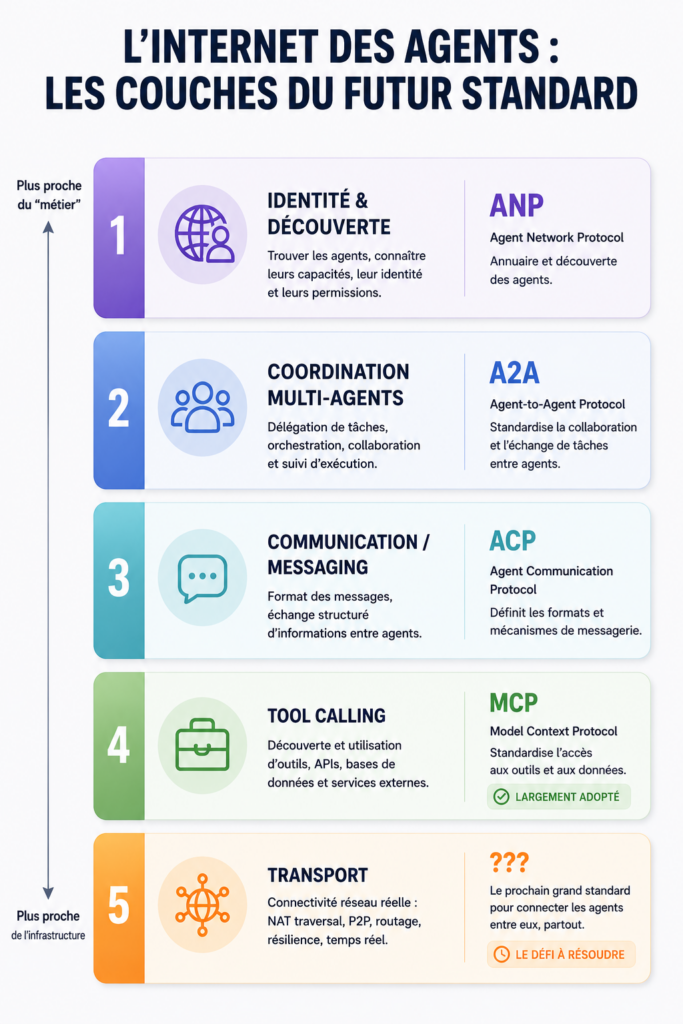
1. Couche Identité & Découverte
-
Protocole phare : [ANP](https://github.com/agent-network-protocol/AgentNetworkProtocol) (Agent Network Protocol)
-
Fonction : Permet de découvrir des agents, leurs capacités, leurs identités et leurs permissions
-
Question clé : « Comment trouver le bon agent et savoir ce qu’il sait faire ? »
2. Couche Communication/Messaging
-
Protocole phare : [ACP](https://www.ibm.com/fr-fr/think/topics/agent-communication-protocol) (conçu par IBM)
-
Fonction : Définis les formats de messages et les mécanismes d’échange entre agents
-
Question clé : « Quel langage ou format utilisent les agents pour communiquer ? »
3. Couche Coordination
-
Protocole phare : [A2A](https://a2a-protocol.org/latest/) (Agent-to-Agent)
-
Fonction : Permet à plusieurs agents de collaborer, se déléguer des tâches et partager leur état d’avancement
-
Question clé : « Comment des agents travaillent-ils ensemble ? »
4. Couche Outils
-
Protocole phare : [MCP](https://modelcontextprotocol.io/docs/getting-started/intro) (Model Context Protocol - conçu par Anthropic)
-
Fonction : Permet à un agent de découvrir et utiliser des outils, APIs, bases de données ou services externes
-
Question clé : « Comment un agent interagit-il avec une ressource ? »
5. Couche Transport : le défi restant
-
Problématique : Le HTTP est largement utilisé malheureusement il ne pourra pas répondre à toutes les contraintes : NAT traversal, routage notamment.
-
Question clé : « Comment les messages circulent-ils physiquement entre les agents ? »
💡 Vers une pile de protocoles pour les agents !
Les couches Outils, Coordination, Communication et Découverte commencent à se structurer. Reste un défi majeur : la couche Transport.
Et si la vraie question n’était plus « Quel protocole va gagner ? », mais plutôt :
« Comment ces protocoles vont-ils s’articuler pour construire l’Internet des agents ? »